科技的日新月異,近來除了蔚為話題的「生成式AI」,除了圖片外,更出現了聲音學習的趨勢,透過將聲音交給 AI 學習,可以仿造出該聲線的作品,這也同樣造成聲音工作者的困擾。
日本法務省近期針對「生成式AI未經同意使用他人聲音或長相」問題正式著手,將成立專家檢討會,並整理這類情況在民事責任上的法律界線。未來會針對每種案例,說明到底算不算侵害「公開權」(名人肖像的商業價值)或「肖像權」,並預計在7月前整理出實務上的指引。對此聲優緒方惠美也對政府開始動作表達讚賞,希望能給業界保障。
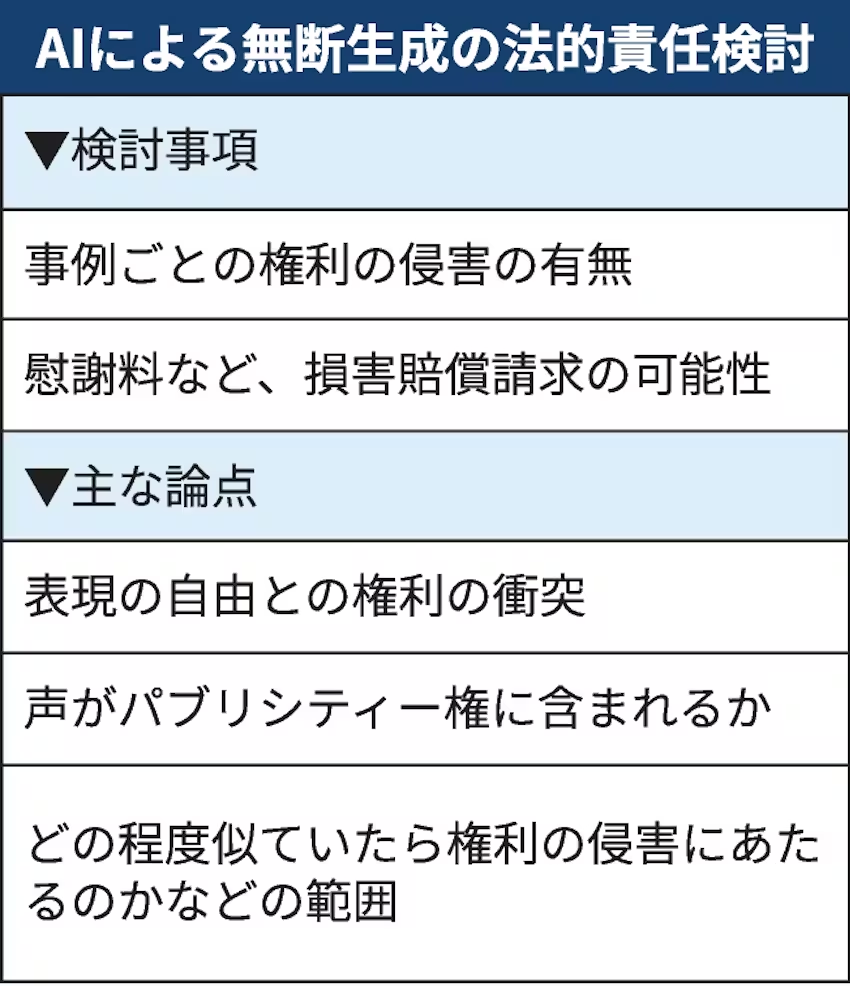
這個檢討會預計在4月24日召開第一次會議,之後會開大約5次會議。會針對各種具體案例,討論到底算不算侵權、求償,最後整理出可供判斷的法律參考標準。目前像是名人姓名、肖像所帶來的商業價值(所謂的「公開權」),或是一般的肖像權,其實在法律條文中都不明確,過去主要都是靠判例慢慢建立起來的。
但隨著生成式AI快速普及,問題也跟著浮現。尤其是「聲音到底算不算肖像權或公開權的一部分」,目前在司法上還沒有一個很明確的定論,成為一大爭議點。
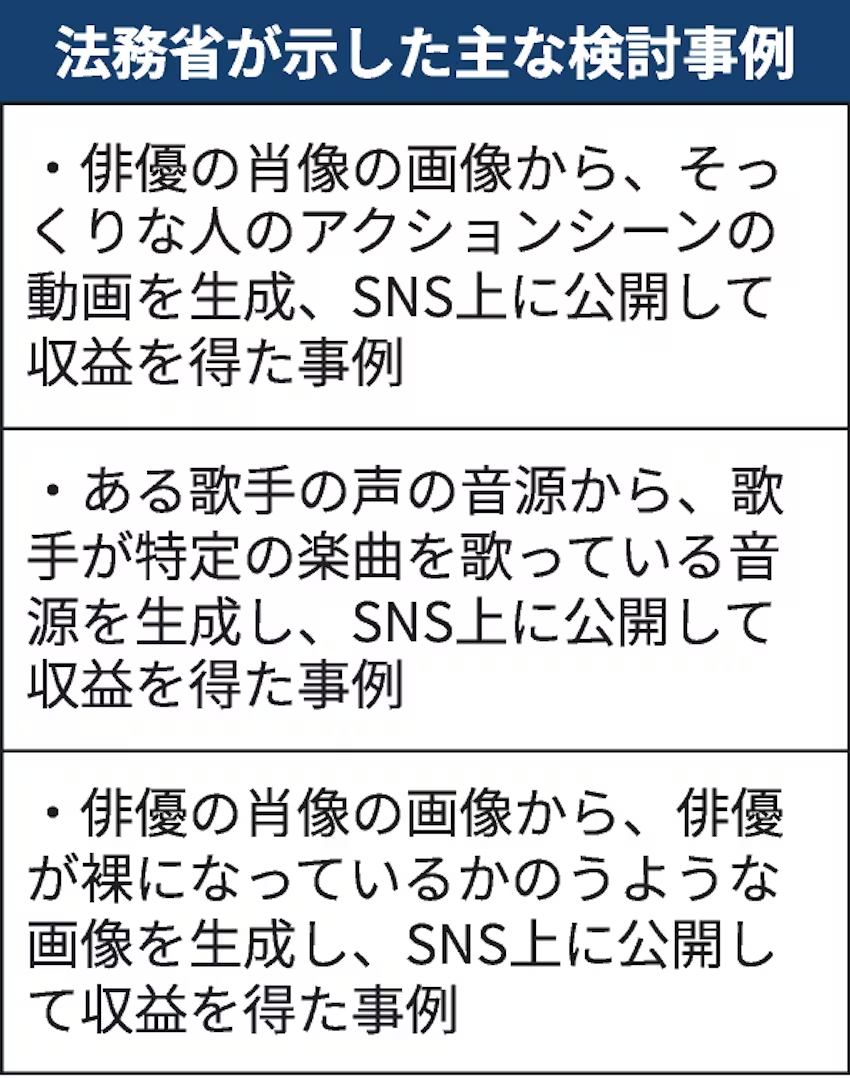
也會特別討論「用AI生成內容來賺錢」的情境,例如:用某位演員的臉,生成一個很像本人在演動作戲的影片、用歌手的聲音資料,生成他唱某首歌的音檔,這些都會被拿來當案例分析。
聲優緒方惠美也轉貼相關新聞並發文表示:「非常感謝一路以來耐心協商的相關人士,以及願意傾聽這些問題的大家。」她也提到「終於算是站上起跑點了」,並強調:「不只是我們,像深偽(deepfake)這類技術,任何人都有可能成為受害者。接下來會持續關注法規的制定。」
不過日本法務省也強調,這次的作法並不是要直接推動新立法,而是先把現行法律的適用範圍整理清楚,讓實務上有依據可循。
整體來看,這次算是日本政府正式開始處理「AI亂用人臉、聲音」這個灰色地帶,先從整理規則開始,後續才可能走到更明確的法律規範。
新聞來源: 日本經濟新聞